为什么科学家不应该给 AI benchmark “做贡献”
如今,打着 open community 的旗号、招募科学家共建 AI benchmark 的项目,可以说是屡见不鲜。流程也大同小异:领域专家出题,验证前沿模型答不出来,被拒了再改,改完再交,直到题目被接收为止。而作为回报,大家拿到的是一篇论文的署名。还有不少项目,从招募一开始,就把“这篇论文要投顶刊”作为招牌,以此吸引人参加。
先说明一点:我并不是在劝科学家远离 benchmark。恰恰相反,我觉得在 AI 时代,科学家的工作会更多地转向设计系统性的 evaluation methodology,以及 problem formulation。好的 benchmark 离不开领域专家,很多好的 benchmark 工作,也确实需要很多人一起来完成。我自己也一直在参与多个 agent evaluation 的工作,既是组织者,也是参与者。
我想讨论的,是眼下一些合作机制中不够公平、不够透明的地方。标题里之所以给“贡献”加上引号,是因为我一直不太喜欢这个说法。“贡献”听起来像是一方把东西交给另一方:项目是组织者的,参与者只是来添砖加瓦。可科研合作本来应该是平等的,大家各自带来不同的专长,一起定义问题,一起完成工作,并不存在谁对谁做贡献。而一旦合作被说成“贡献”,参与者的付出就很容易被看轻:没有话语权,也没有清楚的回报,最后换来的,可能只是一张不知道能不能兑现的支票。
打工 vs 合作研究:边界到底在哪里?
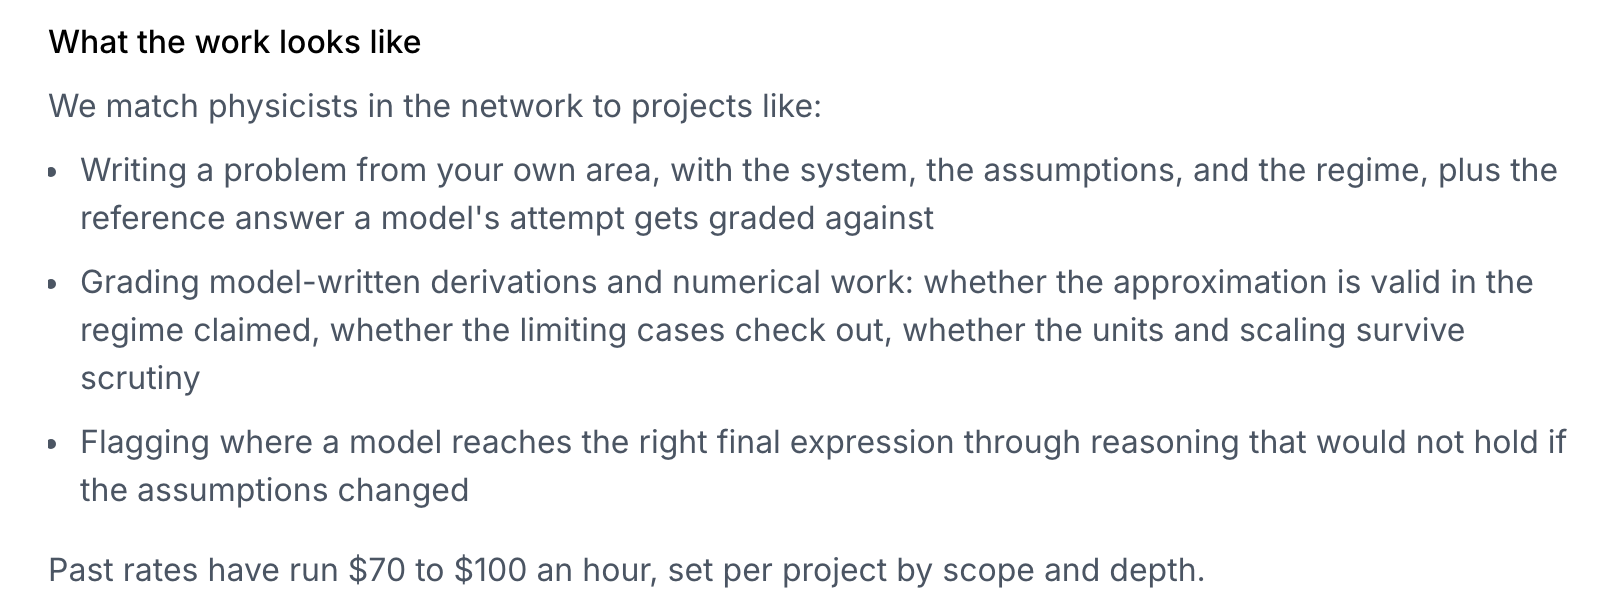
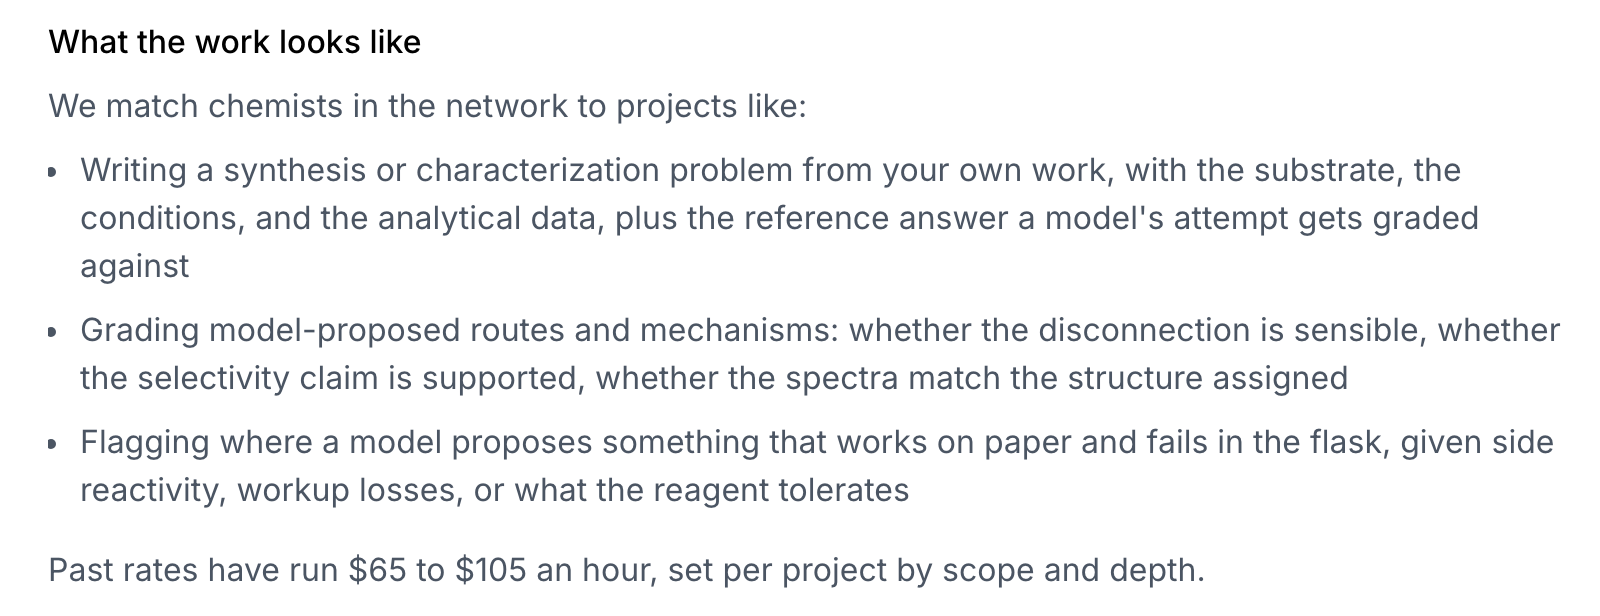
同样的专家工作,在市场上其实是明码标价的。不妨看看 Mercor 给物理学和化学博士开出的长期招聘页面。物理那一页列出的工作内容,第一条就是“从你自己的领域出发写一道题,交代清楚体系、假设和适用范围,再附上用来给模型打分的参考答案”;后面两条,是批改模型写的推导,以及指出模型在哪里“答案对了,推理却站不住”。这几乎就是给 benchmark 出题和审题,一字不差。而页面上写得明明白白:过往的时薪在 70 到 100 美元之间。化学博士的那一页如出一辙,时薪是 65 到 105 美元。
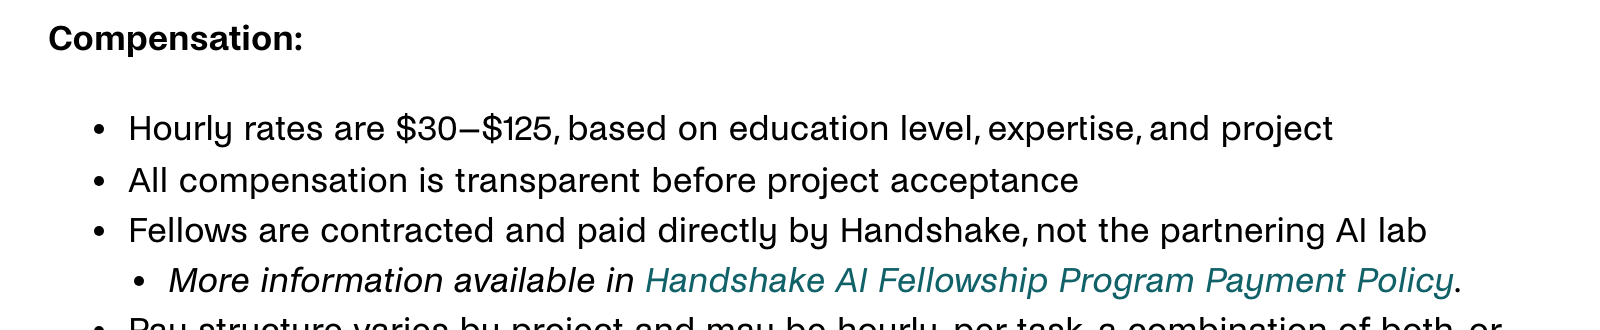
Handshake 的 AI Fellowship 面向的也主要是硕士、博士和博士后。它的 FAQ 写的是时薪 30 到 125 美元,按学历、专长和项目而定,紧接着还有一句:“All compensation is transparent before project acceptance”,也就是接项目之前,报酬就已经完全透明。
学术界的 benchmark 也并非没有付过这样的价钱。GPQA 当年通过 Upwork 雇了 61 位 contractor 来出题和验证题目。每道题有 10 美元的基础报酬,此外还有事先写明的奖金:每有一位领域专家答对,或者每有一位非专家答错,出题人都会多拿一笔。按作者的估算,平均时薪大约是 95 美元。打工本该是这个样子:开工之前,报酬多少、规则如何,都清清楚楚。
那么,如果一个项目不付钱呢?这本身并不是原罪。学术界的许多合作,参与者拿到的本来就不是钱,而是别的东西。只是这样一来,项目能拿出来交换的,就只剩下学术研究的价值本身了。而“学术”二字不能只是一个名义和招牌,它至少应当包含三样东西。
第一是透明的规则。谁做了什么,按什么标准署名,作者顺序怎么排,数据归谁、给谁用,都应当在开工之前讲清楚,而不是等论文快写完了,由少数人关起门来决定。第二是真正的参与。贡献者应当能参与问题的定义和评估标准的设计,能对标准提出异议,而不只是按别人定好的模板交题。第三是成长。在一个正常的合作研究里,参与者能从设计讨论中学到怎样定义一个好问题,能和资深研究者直接交流,而不只是和他们出现在同一篇论文的作者名单上,也能对问题本身有更深的理解。做完之后,这些经验是自己的,可以带进下一项工作。
倘若这三样都给不了,参与者无非是在白白被蒸馏、被剥削。所谓“蒸馏”,是说参与者交出去的,是自己多年积累的领域知识和判断力。这些知识被写成题目和参考答案,变成别人的数据集、别人的 benchmark,最终变成训练和评估模型的信号。知识从人身上被提取出来,沉淀在别人的成果里;而提供知识的人,除了一篇不知道能不能发出来的论文,什么也没有留下。与此同时,组织者收获的却是数据集、影响力,甚至可能还有商业价值。付出和回报如此不对等,说它是剥削,并不为过。
为什么这种合作如此脆弱?
在一个动辄几百人的合作中,组织者和绝大多数被招募来的人之间,其实没有任何直接的约束。没有雇佣关系,信任链条自然十分脆弱。然而,评价贡献、决定作者顺序的标准,却牢牢掌握在少数几个组织者手里。
规模本身并不是问题。粒子物理和引力波领域的大型合作组动辄上千人,大多数合作者之间也没有雇佣关系,却早已形成了一套成熟而公开的署名机制。以 LIGO 为例,它的出版政策白纸黑字地写着:成员在大约一年里把至少一半的研究精力投入合作组,就能获得作者资格,为探测器的设计、建造和运行做出重要贡献的工程师和技术人员同样在列;作者名单由专门的 Elections and Membership Committee 每年 2 月 15 日和 8 月 15 日各发布一次,一律按字母排序。CERN 的 CMS 也是类似的思路:在合作组里满一年,并完成规定时长的 EPR 服务工作,就自动成为作者。早在 2008 年,IUPAP 的粒子与场委员会就在报告中提出:合作组应当对“谁有资格署名”有清楚的内部规则,而且“The rules shall be public and transparent”。
我所在的 XENON 也是如此。文章和作者归属由 Editorial Board 决定;基建工作和具体文章的工作分开计算,大家都参与了基建,所以一起署名,而通讯作者则由这篇文章中专门的数据分析工作量来决定。署名在开始写作之前就会讨论确定,并且在合作组内部公开透明。
可见,大规模的科研合作并不是众包 benchmark 时代才有的新鲜事,而许多合作组早早就意识到了公开、透明的合作标准有多重要。
Red flag 与 Thumbs up:如何判断一个合作是否公平透明
那么,回到众包 benchmark。既然规模不是问题,问题又出在哪里?其实,一个项目是否公平透明,并不难判断,关键是在参与之前把几件事看清楚。下面是我根据自己的观察,以及和身边朋友的交流,总结出的四条标准。它们未必完全准确,也不可能面面俱到,但我觉得可以作为一个好的起点。这四条按参与一个项目的时间顺序排列:招募时、参与中、署名时、发表后。每一条先说 red flag,也就是需要警惕的信号;再说 thumbs up,也就是做得好的项目应当是什么样子,并附上一个真实的例子。
1 · 招募时:确定的回报,还是空头支票?
Red flag:招募时就许诺论文会发在某个顶级期刊上,而论文既没有投出去,更谈不上被接收。这是一个谁都无法兑现的承诺,因为同行评审的结果,从来不在任何人的掌控之中。更值得警惕的是,这张支票瞄准的,恰恰是最需要顶刊文章的那群人:博士生和博士后。一旦承诺落空,贡献者两手空空,也无处追究。
Thumbs up:规范的项目只拿自己兑现得了的东西来吸引人。至于论文最后发在哪里,如果确有投稿计划,可以如实说明,但应当明确这是计划,而不是承诺,更不应该拿它当招牌。Humanity's Last Exam 就是一个例子。它给贡献者的回报只有两样:凡是有题目被接收的人,都可以选择署名;此外还设了固定奖金,前 50 道题每题 5,000 美元,其后 500 道每题 500 美元。题目被接收就能署名,奖金写明了金额,这两样都在组织者自己手里,没有一项需要仰仗审稿人的心情。
2 · 参与中:合作者,还是劳动力?
Red flag:贡献者没有任何渠道参与 evaluation 的设计,只能按既定标准完成任务。而这个标准本身常常含糊不清,完全由少数几位 core author(项目的核心作者)一言堂。除了领域知识和时间,贡献者甚至还要自掏腰包付 token 的钱:为了证明一道题能难住前沿模型,得自己反复调用 API 或者运行 agent;被拒了,改一改,再试一次。
更可惜的是,他们从中几乎学不到什么。在一个正常的合作研究里,参与者至少能收获设计上的思考、与资深研究者的直接讨论,以及对问题更深入的理解。而在这里,这些往往都没有。
Thumbs up:规范的项目会让贡献者参与设计讨论,至少可以对标准提出异议;暂时不符合要求的提交,会得到具体的改进意见和对科学有效性的反馈,而不是被寥寥几句话就关闭;负责审核的资深领域专家,有明确而公开的资格标准,比如须持有本领域的博士学位,或是教授。物理领域的 CritPt 在参与和反馈上做得很好:每道题都要在出题的专家和协调人之间反复打磨,通常三轮以上,最多可达十轮,之后还要经过相近领域研究者的同行评审。更难得的是,论文里坦言,在长达七个月的合作中,专家们对模型表现的一手观察,深刻地改变了这个 benchmark 本身的设计。这才是合作者该有的分量。
3 · 署名时:公开的规则,还是关起门的决定?
Red flag:这类项目的署名,通常会分出等级。有的项目把作者分成 core author、contributor、data contributor 等不同类别;有的项目虽然把所有人都写在同一份名单里,却只把 core author 单独标注出来,而且标注本身还分好几个等级。分等级本身并不是问题,毕竟每个人参与的程度确实不同。真正的问题在于,这些等级怎么划分,往往由 core author 内部决定,参与者无从得知。表面上的标准通常是贡献的题目数量,有时干脆没有标准。而规则一旦不公开,结果就可能取决于和组织者的私人关系或者利益关系,或是所在机构的名气。甚至,作者顺序还可能被随意改动,事先也不和当事人商量。
Thumbs up:规范的项目会在一开始就把各个角色、标准和职责公开在网站上。其中最关键的,是 core author 本身是如何定义、如何产生的。Terminal-Bench Science 就是一个例子。它的 contributing guide 在招募时就写明了整个组织架构和晋升路径:每个被合并的 task 记一个 co-authorship point,满一分即可署名,作者顺序按被接收 task 的数量和影响力决定;贡献突出的人会被邀请成为 reviewer 和 maintainer,对提案审批和 PR 合并拥有投票权;表现良好的 reviewer 还可以成为 area chair,负责一个科学领域;积极引荐贡献者、或以领域专家身份审题的教授,则有资格获得 senior co-authorship。参与其中的贡献者、reviewer 和 advisor,也都公开列在它的 contributors 页面上。每个人都知道自己站在哪里,也知道怎样往上走。
4 · 发表后:自己的成果,还是别人的资产?
Red flag:招募时没有写明 license,也没有说明数据将来会怎么用。等题目收齐了,它们可能被包装成商业产品出售,或者独家提供给某家 AI lab 或公司做内部评测。这些决定直接关系到贡献者劳动成果的去向,理应事先征求他们的意见,实际上却往往由组织者单方面拍板,贡献者甚至毫不知情。与此同时,贡献者对自己出的题还剩下多少权利,也是一笔糊涂账:能不能围绕自己设计的 task 另写一篇论文?能不能把它用在课堂上,或者放进自己的另一个 benchmark?能不能公开发布?没有人说得清楚。
Thumbs up:规范的项目在招募时就把这些写清楚:数据以什么 license 发布,会提供给谁,能不能商用。如果之后有出售或独家授权的打算,应当事先说明,并征得贡献者的同意;贡献者要么参与收益分配,要么至少知情。同时,贡献者对自己出的题保留明确的权利:可以围绕它发表自己的论文,可以用于教学,也可以用在后续的研究里。为了防止数据污染(题目公开后被模型在训练中“见过”)而保留一部分不公开的测试题,本身无可厚非,但这时也应当说明,贡献者在什么条件下、从什么时候起,可以使用和公开自己的题。Agents' Last Exam 在这方面做得比较好:数据集以 CC BY 4.0 发布;按照它的 contributor terms,贡献者授予项目方的是 non-exclusive license,作品的所有权仍在贡献者自己手里。所谓 non-exclusive,就是贡献者把使用权给了项目方,自己却并没有因此失去使用和再授权的权利。
我们应该怎么做?
那么,我们可以做些什么呢?我想,参与者、组织者和整个社区,各自都有一些力所能及的事情。
第一,对参与者。与其去问组织者“这是否是纯粹的学术研究”,不如看看他们白纸黑字写下了什么,毕竟前一个问题的答案几乎总是肯定的。如果项目付钱,报酬应当对得起同样的工作在别处的价格。如果项目不付钱,就拿上面四条逐一对照:回报是否只承诺了兑现得了的东西?你在设计上有没有真正的话语权?署名规则是否公开?license 和数据的去向是否写明?倘若这些都找不到书面的说明,那你其实并不是在“做贡献”,而是在免费打工。
第二,对组织者。在招募之初,就应当把规则写清楚,并且公开出来。首先是 core team:由哪些人组成,如何产生,各自负责什么。其次是贡献者能得到什么:回报是什么,有哪些角色,怎样晋升,署名按什么规则。最后是数据:以什么 license 发布,将来会流向哪里。在项目进行的过程中,暂时不符合要求的提交,也应当得到清晰而恰当的反馈。规则写在明处,本身就是对贡献者的尊重,也是一个项目可信度的一部分。
第三,对整个社区。benchmark 这种依靠大规模协作的科研模式才刚刚起步,多多少少有一些不完善的地方,是再正常不过的事。我在这篇文章中分析这些现象,并不是想指责谁。相反,我自己也是 benchmark 的组织者,上面这些标准,其实也是我在自己的工作中遇到的问题和反思。我希望能与大家一起正视这些问题,共同寻找更好的合作规范,改善眼下这种良莠不齐的现状。而规则清楚、合作公平的项目,理应吸引更多科学家的加入。
在 AI 时代,什么问题值得问,什么样的答案才算对,依然要靠科学家来判断;而这些判断,正在一道道地变成 benchmark 里的题目。正因为它如此重要,才更值得被认真对待。
不过,evaluation 绝不仅仅是设计一个任务,再检查 agent 有没有完成。只走量、不看质,题目出得再多,也说明不了一个系统究竟好在哪里、差在哪里、又该往哪里改进。倘若科学家只是拘泥于出题,而不去研究系统性的 evaluation methodology,不去研究如何据此推动系统的改进,那无疑是捡了芝麻,丢了西瓜。这不只是科学家自己的损失,也是整个领域的损失。
科学家参与 benchmark,不该是一次无偿的“贡献”,更不该沦为一份不付钱的数据标注。它应当是一场平等的合作:大家各取所长,一起定义问题,一起设计 evaluation,一起推动改进。
这也是我所希望看到的未来:科学家不再只是提供数据的人,研究 AI 的人也不再只是负责训练模型的人。AI 终将成为每个人手中的工具。当不同领域、不同背景的人都能在这股浪潮中发展出更全面的技能树,我们对科技的探索,才能够延伸到前所未及的远方。