From STEM to AI:技能、研究与职业方向
最近有不少朋友问我,怎样从 STEM 背景转向 AI。有些人还在读书,希望知道应该从哪里开始;也有些人已经做了一段时间研究,想看看自己积累的知识和经验,在 AI 相关的工作中还能发挥什么作用。这些问题我自己也一直在思考,很愿意和大家交流,只是很难有机会跟每个人都坐下来细聊。因此,我想把目前的一些想法和经验整理成这篇博客。
我自己原来做物理,现在主要做 AI for Science。转向这个方向的过程中,我也一直在摸索该学什么、可以做什么。这篇文章想分享的,就是我目前的一些经验和想法。另外,我还收集了一些工业界的招聘信息,看看有哪些相关岗位,以及它们需要什么能力。
为什么我觉得现在是开始做 AI for Science 的好机会
我开始做 AI for Science 的一个原因,是我觉得 LLM 改变了学习一个新领域的过程。我们可以带着具体问题开始尝试,遇到不懂的地方就追问,在动手的过程中逐渐建立理解。对已经有学科背景、想把 AI 用到自己研究中的人来说,我觉得这是一个很好的机会。
这里我想区分两类工作。第一类是传统的 AI for Science:研究中使用的模型本身不一定是语言模型,但 LLM 可以帮助我们进入这个领域、开展工作。第二类则是围绕 LLM 本身展开的研究和应用。我觉得,这两类工作的方式有很大区别。
对于 LLM,大多数人并没有足够的算力去完成从头到尾的大模型训练。我们更有机会参与的,往往是 evaluation、post-training 和 application。这并不是说这些方向不需要技术积累,而是它们让不同背景的人有了不同的切入点。
根据我自己的经验,在这些工作中尤其重要的,是对具体应用和学科积累的实践知识,以及系统设计能力。
我说的系统设计,不只是软件架构
这里的系统设计,很大一部分当然是 software 和 agent system 的设计。但我想表达的范围更广:面对一个复杂的科学或工程任务,你知道它应该怎样完成吗?过程中可能遇到什么问题?
这些认识往往来自亲自做过这件事,以及长期积累的经验。如果没有实际经历过,很难直接把它们总结出来。也正因为如此,我觉得已有的学科训练和实践经验,在进入 AI 之后依然很有价值。它们会影响我们怎样定义任务、设计流程,以及判断一个系统是否真的把事情做成了。
没有 AI 或 agent 经验,可以怎样开始?
我想把这个问题分成两个部分:一是以前没有做过AI,想开始把机器学习用到科学问题上;二是没有做过LLM agent,想知道应该从哪里进入。这两个方向有交集,但值得关注的事情不完全一样。
做 AI for Science:培养模型与科学问题之间的 taste
如果走的是机器学习应用这条路线,我觉得首先值得关注的是模型架构、数据结构,以及什么样的问题在科学上值得解决。我们的起点未必是机器学习工程,也未必是提出一个非常新的通用模型;我们更可能从自己熟悉的科学问题出发,找到机器学习能发挥作用的地方。
对这条路线来说,一种很重要的判断力是:发现某一类模型适合解决某一类问题,而这类问题本身又有科学价值。我会把这种判断力称为一种 research taste。它需要同时理解方法和问题:模型的结构是什么,数据的结构是什么,两者为什么适合放在一起,以及解决这个问题究竟能带来什么。
所以,对刚开始的人,我更建议围绕这些关系去学习。已有的学科积累能帮助我们判断什么问题重要;接下来需要补上的,是对模型和数据的理解,以及把两者联系起来的能力。
做 LLM agent:先把工具用进自己的工作
对于LLM agent,我觉得没有相关经验也不用太担心。现有的工具大家都可以用,绝大多数人也都没有机会亲自训练背后的前沿模型。我们可以先从使用开始,逐渐理解它是怎么工作的,再尝试改进它。具体把精力放在哪里,可以根据自己的资源和经验来安排。
我的第一个建议,是在日常工作中更多地使用现有工具,比如Codex、Claude Code,以及Google的Antigravity。如果感兴趣,也可以看看OpenHands、Pi、OpenCode这些项目,以及LangGraph这样的agent编排框架。我觉得它们都很有参考价值,学习各自的特点、结构和设计思路,本身就是一件很有意思的事情。
尤其值得关注的是自己领域中面向具体科学任务的agent,以及相关研究。你不一定需要把每个工具都试用一遍,但应该尽量搞清楚它们的设计逻辑:为什么这样组织工作?可能擅长什么、不擅长什么?瓶颈在哪里?理解这些,比只是知道一个工具的名字更重要。
从使用走向改进:先定义什么叫“变好了”
第二个建议,是在使用的过程中多考虑怎样改进。但改进需要一个基准:我们得先有评价体系,才知道一次改动是否有效。这里有个很难也很重要的问题——怎样把“感觉好用”或“感觉不好用”,变成可以测量、比较的东西?
Humanity’s Last Exam(HLE)和Agents’ Last Exam(ALE)是两个很有代表性的例子。HLE收集了跨学科的高难度问题,关注模型能否给出正确答案。ALE则把评估对象放到了实际的专业工作流程上:由250多位行业专家参与设计,覆盖13个行业大类、55个子领域的一千多个任务,要求agent经过多步执行,完成有可验证结果的工作。
这两个例子放在一起,很容易看出我们需要评估的能力发生了什么变化。面对一道题,我们主要检查答案;面对一项工作,还要看agent能否组织步骤、使用工具、处理执行中出现的问题,最后交付符合要求的结果。我在自己整理的SciEval网站里收集了更多这类科学与工程评估工作,有兴趣的话可以从中找找与自己领域相关的任务。
再往下想,还有很多很具体的问题。比如,怎样才算有效的探索?一个agent连续跑了十次实验,指标都没有提高,但排除了一个错误假设,让我们知道应该换一个方向,这段探索有没有价值?反过来,如果它只是反复尝试相近的方案,即使偶尔碰到了更好的结果,我们又该怎样评价它的探索能力?
性价比也需要放到具体任务里讨论。两个agent最后得到了差不多的结果,一个花了十分钟,另一个花了几个小时;有的消耗更多token,有的需要昂贵的模拟或GPU实验,还有的需要人反复纠正。我们可以比较同样预算下谁做得更好,也可以比较达到同样目标各自需要多少资源。如果多花一倍计算只能换来很小的改进,这样的改进是否值得,就要看实际任务的需要。
还有一个我觉得很有意思的问题:一条很长的执行轨迹里,哪些才是关键步骤?可能是发现了数据里的一个问题,选对了验证方法,也可能是在实验失败后改变了计划。后面即使写了很多代码、调用了很多工具,真正决定结果的也可能只是前面的某个判断。怎样识别这些步骤,判断它们对结果有多大贡献,甚至检验换掉这一步之后会发生什么,都是值得研究的问题。这样的评估也能帮助我们知道,下一步到底应该改进agent的哪一部分。
科学和工程经验为什么能帮助我们做评估
最近LLM在数学上的成果是有目共睹的。OpenAI近期公布的模型生成证明稿,已经涉及Navier–Stokes问题这样的千禧年难题,以及挂谷猜想相关问题。仅在10月公开的数学研究成果中,就有七百多份研究稿件。看到这样的进展,很自然会想到:LLM在其他科学和工程领域,又能走到哪里?
我觉得这里值得注意的是,不同领域有不同的难点和瓶颈。数学推理能力很重要,但完成一项科学或工程任务,还可能取决于对数据、实验条件和实际流程的理解。模型会不会推导,和它能不能发现测量出了问题、判断一个近似是否适用、把实验结果复现出来,需要分别检验。也正是在这些地方,理工科训练和亲自做过研究的经验能够发挥作用。
许多数学证明任务的目标相对明确:在给定的定义和假设下,论证是否成立?如果证明完整,读者可以沿着论证检查。科学与工程研究则经常包含大量经验性的细节。即使论文写得认真,也很难把实际操作中的每一件事都交代清楚;读懂论文和真正复现结果,往往还隔着一段距离。这里一部分是documentation的问题,另一部分是任务本身就不容易被完整描述和量化。
亲自做过科学和工程工作的人,更有机会意识到哪些细节被省略了,哪些结果需要进一步检查,以及什么样的成功才有实际意义。我认为,这些经验能够帮助我们设计更贴近真实工作的任务和评价标准。
我期待LLM下一步更多地落到实际工作中,真正加速科学与工程任务。在我看来,从模型展示出的能力,到稳定地帮助人完成这些任务,仍然存在很大的距离。它的潜力还没有被充分释放出来,而这也正是我觉得值得投入的地方。
从 STEM 转向 AI,可以关注哪些工作机会?
如果想从STEM转向AI,我们已有的研究经验能用在哪些工作中,又需要补上哪些能力?带着这些问题,我整理了108家公司的841条相关岗位,并统计了它们涉及的能力。筛选时,我关注的是有STEM背景的人经过进一步学习和项目实践,有希望申请的工作。我想看看这些岗位需要哪些能力,也为接下来的学习和项目选择找一些具体的参考。
这些公司既有大厂,也有AI实验室、应用型创业公司和AI for Science团队。下面是截至2026年10月30日收集到的公司分布。后面的图表分别展示美国岗位和全球岗位:美国部分包含611条岗位、92家公司;全球部分包含841条岗位、108家公司,其中包括美国岗位。
| 类别 | 美国 | 全球(含美国) |
|---|---|---|
| 大厂/上市公司 | 31 | 31 |
| 独角兽 | 43 | 49 |
| 其他 startup | 18 | 28 |
怎样看懂一个岗位在做什么
刚开始看AI岗位时,很容易遇到一长串陌生的技术名词。我觉得可以先从工作内容读起:这个团队想解决什么问题?招来的人具体要做什么?比如,同样提到evaluation,有的工作更关注怎样设计实验、分析结果,有的则需要搭建一套能持续运行评估的软件系统。把这些事情想清楚以后,再回头看技能要求,就比较容易判断,自己已有的经验能用在哪里,还有什么值得补上。
这些岗位中常见的能力
| 类别 | 纳入内容 |
|---|---|
| E · Evaluation | 模型或agent质量测量、benchmark、grader、失败分析 |
| H · Agent harness | agent执行、工具、环境与任务编排 |
| P · Post-training | 明确的微调、偏好优化及后训练方法 |
| M · ML建模 | 模型或算法设计、研究与训练 |
| S · Systems | 生产系统、推理服务、分布式执行与数据基础设施 |
| D · 领域知识 | 具体科学或技术领域的专长 |
| T · 统计与实验 | 抽样、不确定性、对照实验与可复现性 |
| R · RL与奖励 | 强化学习、奖励设计与策略优化 |
这些能力在实际工作中经常结合使用。例如,搭建一个评估平台,既要设计评估任务和指标,也要处理数据、运行实验、记录结果。Systems涵盖的工作则包括数据管道、模型部署、多GPU推理优化等,可以结合自己的经验和兴趣,选择其中一个方向深入。
哪些能力经常用得上?
把这些岗位放在一起看,可以发现一些反复出现的能力。下面这张图可以作为选择学习方向的参考,再结合具体岗位,看看哪些与你的经验和兴趣比较接近。
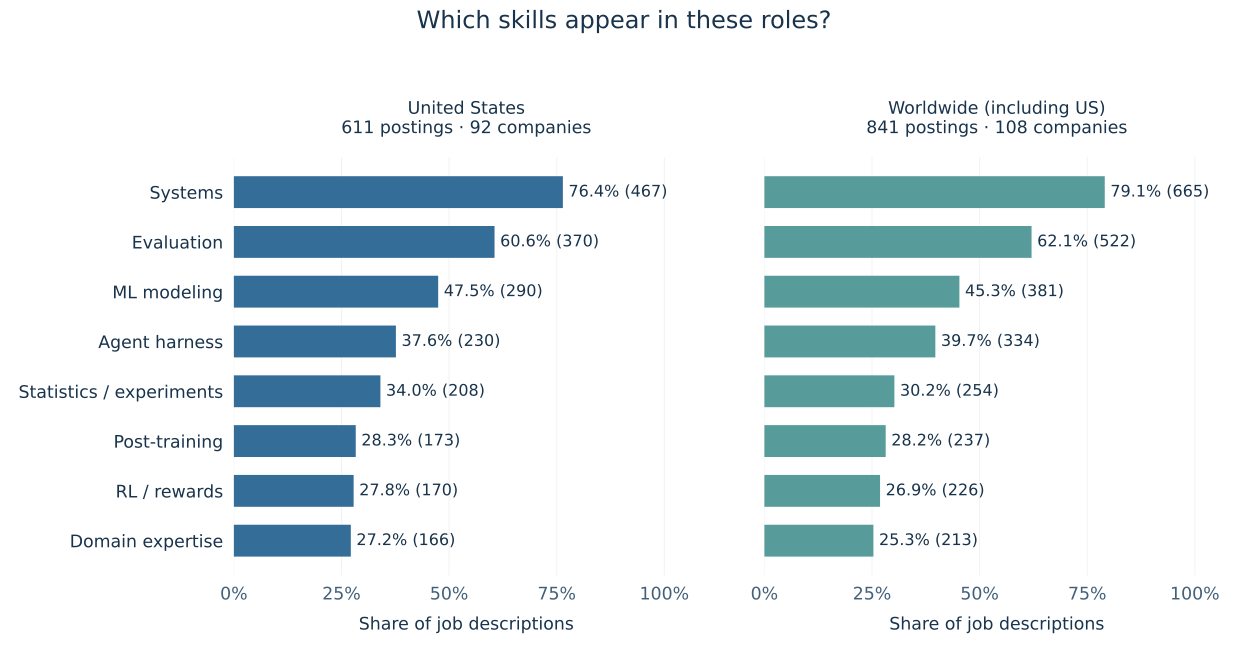
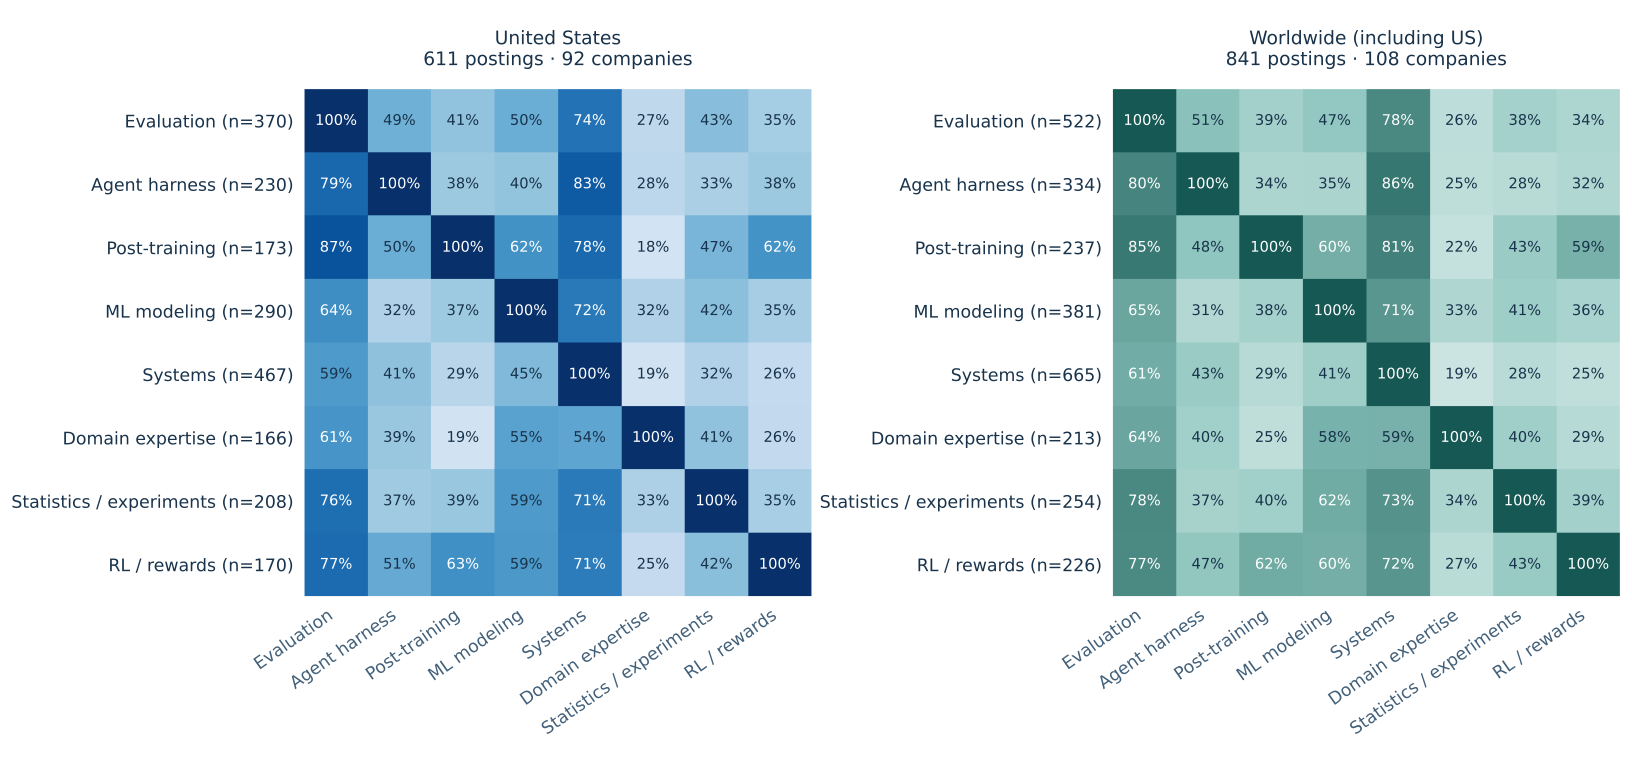
两组岗位中,Systems和evaluation都出现得最多。在美国岗位里,涉及这两类能力的比例分别是76.4%和60.6%;全球岗位中则分别是79.1%和62.1%。评估也经常与系统开发一起出现:美国220条提到evaluation、没有提到post-training的岗位中,159条涉及systems。这呼应了前面讨论的两个方面:怎样判断AI做得好不好,以及怎样把整个任务流程搭建起来。
| 能力组合 | 美国 | 全球(含美国) |
|---|---|---|
| 涉及evaluation | 370 / 611 · 60.6% | 522 / 841 · 62.1% |
| Eval岗位中同时涉及post-training | 150 / 370 · 40.5% | 201 / 522 · 38.5% |
| 未提及post-training的Eval岗位中涉及systems | 159 / 220 · 72.3% | 245 / 321 · 76.3% |
几类值得关注的工作,以及需要的技能
方向一:评估与应用数据科学
我觉得,评估与应用数据科学是有定量研究经验的人可以关注的一个方向。模型更新了,效果究竟有没有变好?评估里选的问题,能不能反映用户实际遇到的情况?如果一个指标提高了,我们又怎么知道,这个变化来自模型本身,还是测试数据的选择?这些问题需要统计分析、实验设计,也需要对具体任务的理解,和我们在科学研究中经常做的事情有不少相通之处。
如果你平时的研究就涉及处理数据、设计对照实验、分析误差,可以从这里开始探索。接下来值得熟悉的,是LLM和agent的评估方法,以及怎样把自己的分析过程做成可以反复运行的工具。前面提到的,把“好不好用”这样的感受变成可以测量和比较的东西,在这类工作里会变得很具体。
举一个实际的例子,Microsoft的Senior Data Scientist for Copilot Evals就很关注这些问题:评估集是否覆盖了真实的用户需求,自动评分是否可靠,以及离线测试中的进步,是否也体现在用户使用Copilot的体验中。这里的统计和实验能力,会直接影响团队怎样判断产品质量、决定下一步改进什么。
方向二:Agent与研究工具开发
还有一类工作,是把模型、工具和实验流程连接起来,让AI能够完成一个比较复杂的任务。比如,让agent提出一个代码修改,再自动编译、测试、测量性能,最后根据结果继续改进。这里需要考虑的事情,和前面讲的系统设计很接近:任务怎样拆分,工具怎样调用,中间结果怎样保存,出了问题以后又该从哪里继续。
如果你做过科学计算,或者为自己的研究搭建过一套实验和数据处理流程,可以进一步探索这个方向。编程、软件结构和调试会比较重要,也需要熟悉agent的工具调用、状态管理和评估。随着任务变大,并行运行、资源分配和运行成本也会成为需要解决的问题。
例如,AMD的ML Systems Research Engineer, RL / Inference / Agent Systems(92704)就要搭建这样的研究系统。它面对的工程任务,有些验证过程需要几分钟甚至几个小时。因此,工作中既要安排模型生成候选方案,也要组织验证、保存实验结果,把有用的反馈送回下一轮尝试。这是科学计算和实验流程方面的经验可以发挥作用的地方。
方向三:模型研究与科学应用
如果你更喜欢研究模型本身,或者希望用机器学习解决熟悉领域里的问题,也可以关注模型研究和科学应用方面的工作。这里会更经常地涉及模型结构、训练方法、数据的组织方式,以及怎样设计实验来检验一个想法。前面说的taste,在这类工作里很重要:理解问题的特点,判断什么模型值得尝试,再通过实验找到它有效和失效的原因。
这个方向需要较扎实的机器学习基础,以及用PyTorch等框架实现和修改模型的能力。对于科学应用,领域知识同样重要。你需要知道数据是怎样产生的,哪些规律和约束应该被考虑,以及怎样的结果才对这个领域有意义。
举一个结构化数据方面的例子,SAP的Senior AI Researcher – Relational Foundation Models(REF2073B)研究的是怎样让模型从多张相互关联的数据表中学习,并适应不同的预测任务。工作包括设计模型和训练目标、运行GPU实验、做对照和消融分析。它涉及的Transformer、图学习和关系数据建模,也给出了一个很具体的学习方向:从自己熟悉的数据结构出发,逐渐深入适合它的模型方法。
如何开始你的第一个项目
说了这么多方向,最后还是要回到一个很实际的问题:第一步可以做什么?我自己的建议,还是从熟悉的领域出发。找几篇相关的论文,看看大家关心什么问题,已经尝试了哪些方法,再想想自己研究中有没有一个具体的环节,可以用模型或agent来改进。比如,尝试用一个已有的模型处理你熟悉的数据,或者把平时反复进行的数据分析和模拟流程,整理成一个agent能够执行的任务。做的过程中,你会逐渐知道自己缺什么,也更容易判断下一步该学什么。
先尝试一篇workshop paper,或者一个开源项目
如果希望做研究,一开始可以先以一篇相关workshop的paper为目标。选一个范围比较明确的问题,复现一个已有方法,再试着做一些改进,把你观察到的结果和问题整理出来。这个过程也能帮助你熟悉AI研究的工作方式,找到愿意讨论类似问题的人。
如果做出来的是一个工具,也可以把它放到GitHub上。写清楚它解决什么问题,给一个别人可以运行的例子,再邀请同领域的朋友试一试。别人使用时碰到的困难,常常会告诉你一些自己没有注意到的问题。如果这个工具确实帮到了他们,就可以继续改进,看看能不能用到更多任务上。
我觉得,值得重视的是让自己的工作产生实际影响。论文、开源代码、被别人使用的工具,都可以是分享成果、让别人了解你在做什么的方式。早点把一个具体的想法做出来,也能更早地获得反馈,找到接下来值得投入的方向。
找背景互补的人一起做
还有一个很实际的建议,是找AI或CS背景、同时对AI for Science感兴趣的同学和朋友合作。你熟悉科学问题,知道数据从哪里来、现有方法有什么困难,也能判断结果是否有意义;对方可能更熟悉模型、训练方法和软件实现。一起读几篇论文,选一个双方都觉得有意思的问题,从小项目开始,会是一个很好的学习过程。
在合作中,也可以多花些时间理解对方是怎样思考的。为什么选择这个模型?这个实验能说明什么?科学上的哪些条件会影响方法的设计?这些讨论会慢慢帮助你把原来的领域经验和新的技术联系起来,也形成自己的判断。
现在获取知识、开始学习一个新领域,已经比过去方便了很多。遇到不懂的概念,可以和LLM反复讨论;想尝试一个方法,也可以借助coding agent更快地动手。因此,可以早点开始这些探索。在真实的问题中边学边做,逐渐找到自己感兴趣、也愿意继续投入的事情。
公司覆盖与来源说明
招聘信息来自公司官网和公开招聘平台,借助agent收集、阅读和整理。截至2026年10月30日,全球统计覆盖108家公司、841条岗位;其中美国统计覆盖92家公司、611条岗位。公司名单如下:
Aaru · Abridge · Adobe · Affirm · AI21 Labs · Airbnb · Aleph Alpha · Alphabet · AMD · Anthropic · Anyscale · Arthur AI · AssemblyAI · Baseten · Block · Braintrust · Cartesia · Chai Discovery · Cognition · Cohere · Confident AI · CoreWeave · Crusoe · CuspAI · Databricks · DatologyAI · Decagon · Deepgram · Duolingo · Dynatrace · ElevenLabs · Factory · fal · Figure AI · Fireworks AI · Generate Biomedicines · Genesis Therapeutics · Glean · Goodfire · Gray Swan AI · H Company · Harmonic · Harvey · Iambic Therapeutics · idler · Instacart · Labelbox · LangChain · Latent Labs · Lightning AI · Lila Sciences · Liquid AI · LlamaIndex · Lyft · Magic · Mechanize · Mercor · Meta · Microsoft · Mistral · Modal · MongoDB · Nous Research · NVIDIA · OpenAI · Oracle · Oratomic · Orbital Materials · Owkin · Patronus AI · Periodic Labs · Perplexity · Physical Intelligence · PhysicsX · Pinterest · Poolside · Prime Intellect · Profluent · Prolific · Qualcomm · Ragas / Vibrant Labs · Recursion · Reddit · Reflection AI · Reka AI · Roblox · Runway · Sakana AI · Salesforce · Samsung Research · SandboxAQ · SAP · Scale AI · ServiceNow · Skild AI · Snorkel AI · Snowflake · Sourcegraph · SpaceX · Spotify · Thinking Machines · Toast · Together AI · Turing · TwelveLabs · V7 · Vals AI · Writer